- In Linux, le pipe permettono di concatenare i processi collegando stdout e stdin, con il supporto del kernel e strumenti come tee, xargs e cpio per flussi complessi.
- Una pipeline CI/CD efficiente in Linux si basa su una buona progettazione degli stadi, un uso intensivo delle cache, artefatti immutabili e test paralleli.
- L'ottimizzazione del server Linux (CPU, RAM, I/O, Docker) e degli executor di Jenkins, GitHub Actions o GitLab Runner è fondamentale per ridurre i tempi.
- L'integrazione di sicurezza, osservabilità e controllo dei costi nella pipeline garantisce implementazioni affidabili, tracciabili e sostenibili negli ambienti di produzione.
Ottimizzazione delle pipeline in Linux Non si tratta solo di concatenare comandi con il simbolo |Dietro tutto ciò si cela un intero mondo di ottimizzazione delle prestazioniLa progettazione del flusso di lavoro, la CI/CD, la sicurezza e l'ottimizzazione del sistema operativo fanno la differenza tra una pipeline lenta e instabile e una veloce, affidabile ed economica da mantenere. Se lavori con server Linux, che si tratti di automatizzare attività da terminale o di eseguire pipeline di integrazione continua, comprendere questi dettagli ti farà risparmiare molto tempo e grattacapi.
In questo articolo combineremo due prospettive complementari: da un lato, la Uso classico delle pipe nella riga di comando di Linux (pipe, reindirizzamenti, comandi come tee, xargs o cpio); dall'altro, il Ottimizzazione della pipeline CI/CD su server LinuxQuesto include caching, parallelizzazione dei test, ottimizzazione di Docker, sicurezza della catena di fornitura e metriche avanzate del flusso di lavoro. Il tutto spiegato in spagnolo (dalla Spagna), con esempi chiari e un approccio molto pratico.
Cos'è una pipeline e come si integrano le pipe in Linux?
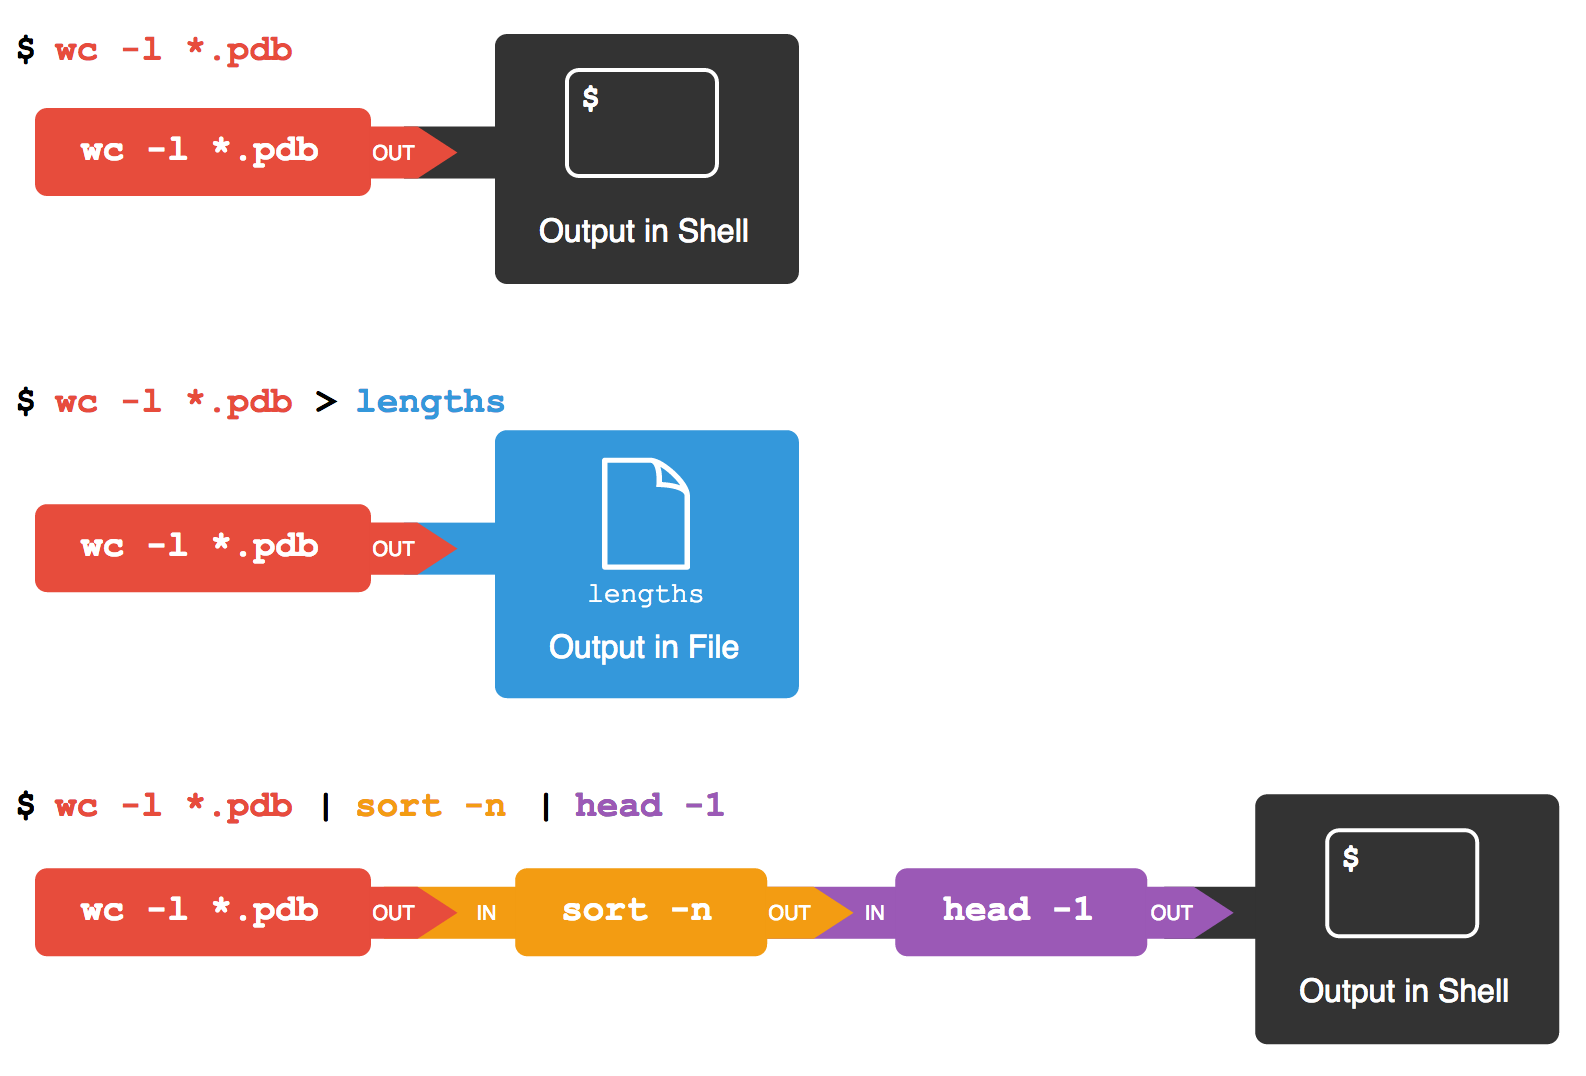
Il termine pipeline deriva dall'idea di tubo : un flusso di dati che viaggia da un punto all'altro. In informatica, e in particolare in Linux, una pipe è un meccanismo che permette all'output standard di un processo di diventare l'input standard di un altro. In altre parole, l'output di un comando viene automaticamente passato al successivo senza transitare attraverso file intermedi.
Nei sistemi Unix-like, esistono due tipi principali di pipe . Da un lato, ci sono le pipe anonime o senza nome , che possono essere utilizzate solo tra processi strettamente correlati (ad esempio, padre e figlio). Dall'altro lato, ci sono le pipe con nome , note anche come FIFO (First In – First Out), che consentono la comunicazione tra processi non direttamente correlati e che possono trovarsi anche su macchine diverse connesse in rete.
Le pipe anonime in genere consentono una comunicazione unidirezionale : un processo scrive e l'altro legge. Al contrario, le pipe con nome permettono una comunicazione bidirezionale se progettate in tal senso, ad esempio aprendo la FIFO in modalità lettura/scrittura da entrambe le estremità. Sono ampiamente utilizzate per coordinare processi daemon, script o servizi che necessitano di scambiarsi dati senza bloccarsi.
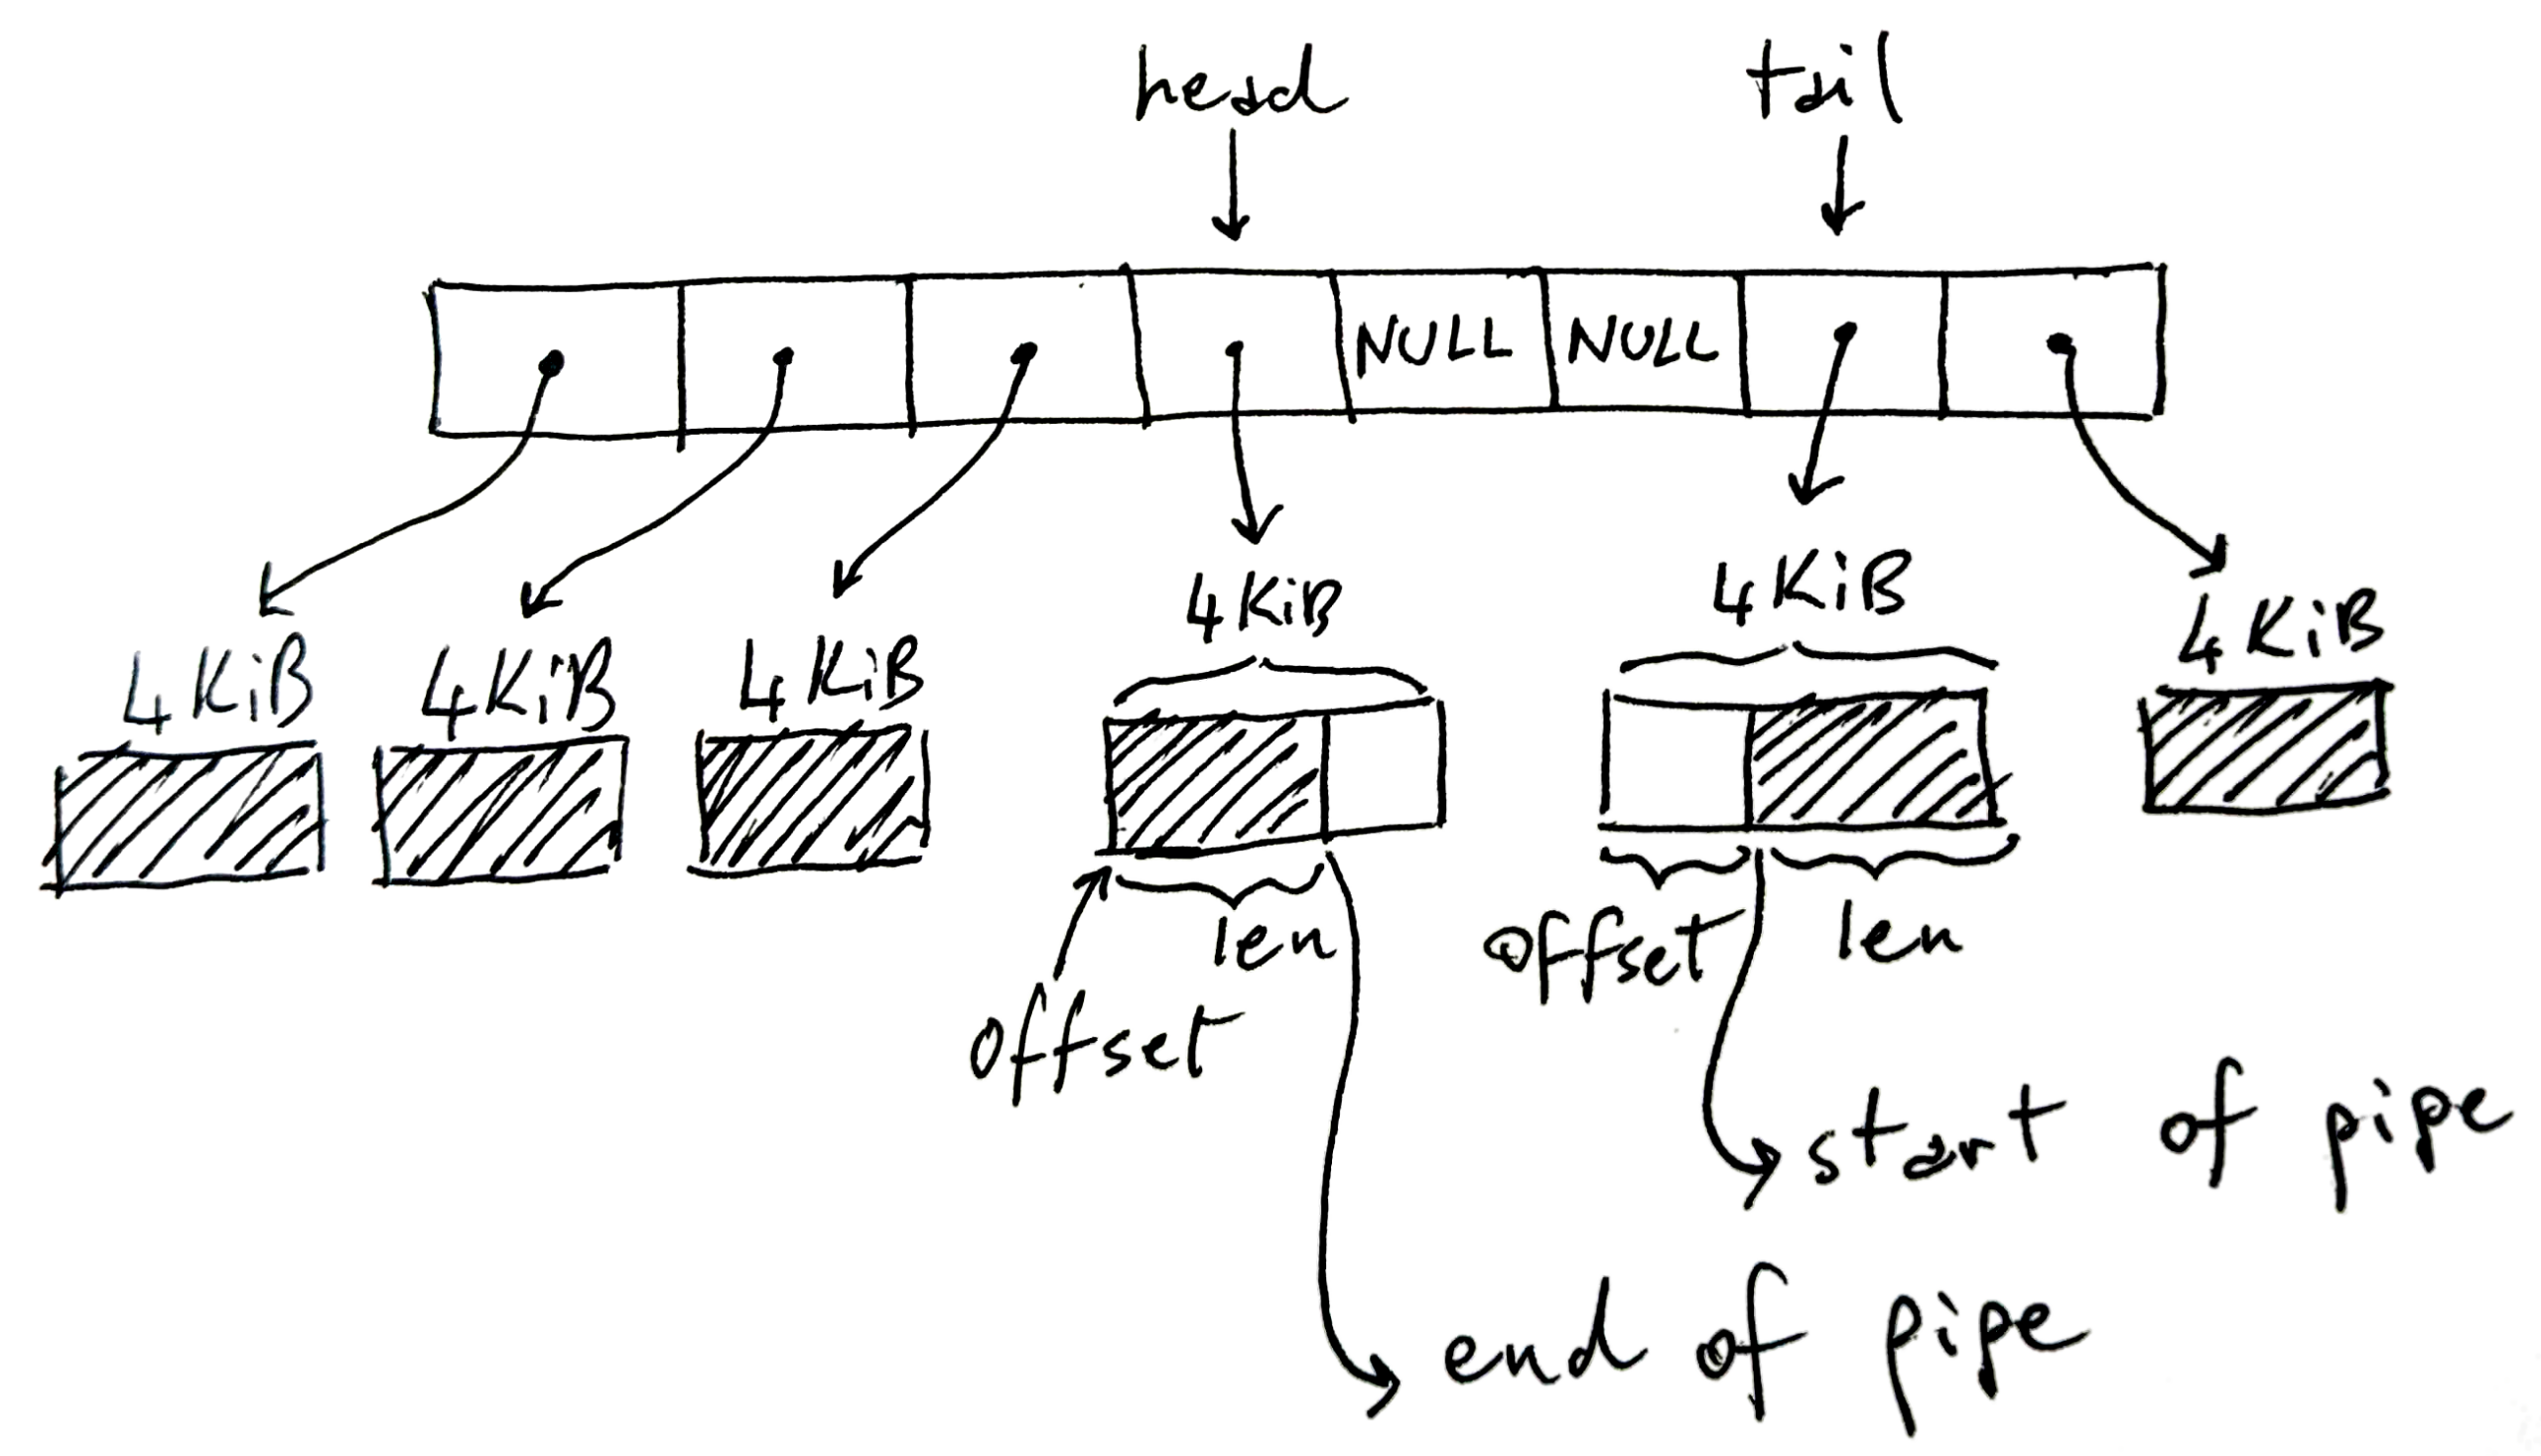
A livello di implementazione, il supporto per le pipeline è in kernel linuxnon nella shell. L'interprete dei comandi (bash, zsh, ecc.) crea semplicemente la pipeline tramite chiamate di sistema come pipe() y fork()Il sistema reindirizza i descrittori di file e poi avvia ciascun programma. La vera magia del blocco dei processi, della gestione del buffer e della propagazione dei dati tra produttore e consumatore è gestita dal kernel di sistema.
Comprensione di stdin, stdout e flusso di dati
Per lavorare efficacemente con le pipeline, è fondamentale comprendere cosa siano stdin, stdout e stderr . Non si tratta di concetti astratti: ogni processo in Linux inizia con tre descrittori di file aperti, che puntano a risorse specifiche gestite dal kernel.
stdin (descrittore 0) e stdout (descrittore 1) possono essere visti come flussi di byte connessi a qualcosa: potrebbe essere un terminale, un file, un socket di rete o una pipe. Non sono semplici buffer; sono riferimenti a oggetti del kernel ( strutture di tipo file ) che a loro volta sono associati a inode, socket o strutture interne di pipe.
Ogni processo ha i propri descrittori, in modo che ogni comando in una pipeline Visualizza il suo stdin e stdout in modo indipendente. Su una riga come ls | grep txt | wc -l, la ls scrivere in una pipa, grep Legge da una tubatura e scrive su un'altra, e wc Leggi dall'ultimo. All'utente appare come una singola stringa, ma internamente sono buffer del kernel concatenati multiplicon ogni processo che si blocca e riprende a seconda dello spazio o dei dati disponibili.
Quando il primo processo produce dati più velocemente di quanto il secondo li consumi, il buffer della pipe si riempie. A quel punto, le scritture successive restituiscono un valore, bloccando il processo mittente finché il processo consumante... leggere informazioni sufficienti e libera spazio. Ciò impedisce che la memoria vada fuori controllo; i dati non si accumulano indefinitamente a meno che non si utilizzino I/O non bloccanti o segnali speciali. Ad esempio, in un caso come dd if=/dev/sda | gzip -9e gzip si comprime più lentamente, dd è costretto ad aspettare.
Questo meccanismo di contropressione rende le pipeline piuttosto stabili anche in presenza di squilibri prestazionali tra le fasi, un aspetto che si riflette poi nella progettazione delle pipeline CI/CD , dove le fasi più lente diventano il collo di bottiglia che deve essere misurato e ottimizzato.
Utilizzo pratico delle pipe nel terminale Linux
Nell'uso quotidiano, le pipe vengono utilizzate per concatenare comandi su un'unica riga e trasformare i dati passo dopo passo. Invece di eseguire un comando, osservarne l'output, copiarlo e incollarlo in un altro comando, è possibile creare piccole e flessibili "fabbriche di dati" in testo semplice.
Un esempio tipico negli ambienti Unix è la combinazione del comando fortune, che mostra citazioni casuali, con cowsayche stampa una mucca "parlante". Quando si usa un tubo, La partenza di Fortune diventa il messaggio di CowsayTutto con un unico comando. È un esempio giocoso, ma illustra perfettamente l'idea di collegare strumenti semplici per svolgere compiti più complessi.
Un altro classico è inviare il risultato di ls a wc per contare righe, parole e caratteri. Qualcosa del tipo ls | wc Consente di vedere rapidamente quanti articoli sono elencati. Il bello è che non serve un unico programma per fare tutto, ma piuttosto... Si creano soluzioni con utility piccole e ben progettate..
È anche molto comune concatenare cat, sort y more (o un altro pager) per ordinare un file di testo e poi sfogliarlo pagina per pagina. Con una pipe, il contenuto passa da un comando all'altro senza essere salvato in file temporanei espliciti, il che semplifica notevolmente la programmazione e le attività amministrative.
In casi pratici come l'elaborazione di elenchi di studenti e voti in file separati, è possibile utilizzare paste per unire le colonne, cut per selezionare solo i campi che ti interessano e pipe concatenate per filtrare, ordinare o trasformare tutto in una singola riga di script shell. Questo modello di suddividere un problema complesso in semplici comandi combinati con pipe È l'essenza della filosofia Unix.
Comandi avanzati per sfruttare al meglio le pipe: tee, xargs e cpio
Quando si inizia ad automatizzare seriamente i processi in Linux, le pipe diventano ancora più potenti grazie ad alcuni strumenti chiave. Tra questi: tee, xargs y cpioche si integrano molto bene con il flusso di dati standard.
Il comando tee Si comporta come una "T" in un tubo dell'acqua: legge da stdin, scrive su stdout e copia anche lo stesso output in uno o più file. È ideale quando si desidera visualizza l'output sullo schermo e, allo stesso tempo, salvalo per rivederlo in seguito o elaborarlo in un'altra fase. Con l'opzione -a Aggiunge i dati alla fine del file anziché sovrascriverlo.
Ad esempio, puoi ordinare un elenco con sortinviare il risultato a tee per memorizzarlo in un registro e, allo stesso tempo, passarlo a more per impaginarlo. In questo modo, in un unico flusso di lavoro, si ottengono l'ordinamento, il salvataggio su disco e una comoda visualizzazione senza dover ripetere il processo di ordinamento.
Il comando xargs È un altro elemento fondamentale quando si parla di pipe. La sua funzione è quella di prendere ciò che arriva tramite stdin (di solito un elenco di elementi) e convertirlo in argomenti per un altro comando. È particolarmente utile quando un programma si blocca perché riceve troppi parametri contemporaneamente o quando si desidera suddividere il lavoro in lotti con l'opzione -n, che limita il numero di argomenti passati per ogni esecuzione.
Ad esempio, con ls | xargs -n 4 Si divide l'elenco dei file in gruppi di quattro, eseguendo il comando di destinazione (per impostazione predefinita echo(o quello che specifichi) più volte. In questo modo puoi creare pipeline come "anteprima di ciò che sto per eliminare" combinando ls, xargs y echo rm prima di avviare la cancellazione vera e propria.
Fai attenzione agli input complessi: percorsi con spazi o caratteri speciali può interrompere il comportamento predefinito di xargsIn questi casi viene solitamente utilizzato in combinazione con find e l'opzione -print0, che separa gli elementi con un carattere nullo, insieme a xargs -0 in modo che entrambe le estremità utilizzino lo stesso delimitatore robusto.
Infine, cpio È un comando meno conosciuto rispetto a tarMa è incredibilmente flessibile per lavorare con flussi di file tramite pipe. A differenza di tar, è progettato fin dall'inizio per funzionare con reindirizzamenti e pipe: riceve un elenco di file tramite stdin (di solito generato con find) e produce o consuma file di tipo "pacchetto" senza la propria compressione, che puoi poi comprimere con gzip o simili.
Le principali modalità di cpio consentire la creazione di file (-o), copia alberi di directory (-p) o estrarre il contenuto (-i(spesso indicato come “copia”). Opzioni come -u per sovrascrivere, -m per preservare i timestamp o -d ricreare la struttura delle directory rende possibile per controllare nel dettaglio cosa viene copiato e come, particolarmente utile negli script complessi dove tar non è all'altezza.
Progettazione e ottimizzazione di pipeline CI/CD su server Linux
Oltre alla tradizionale riga di comando, il concetto di pipeline è diventato fondamentale nel mondo dell'integrazione continua e della distribuzione continua (CI/CD) . Su un server Linux, una pipeline CI/CD è una sequenza automatizzata di passaggi: scaricare il codice, installare le dipendenze, compilare, eseguire i test, impacchettare gli artefatti e distribuire.
Linux è particolarmente adatto a questo scopo perché si distingue per velocità, stabilità e un ecosistema di strumenti di automazione . Piattaforme come Jenkins, GitHub Actions e GitLab CI si affidano agli executor Linux (macchine fisiche, macchine virtuali o container) per eseguire le pipeline in modo coerente.
Ottimizzare queste pipeline significa non solo farle "funzionare", ma farle funzionare con il minor attrito possibile. Ciò implica ridurre i tempi di checkout, minimizzare le installazioni ripetitive delle dipendenze, ottimizzare le immagini Docker per evitare ricostruzioni non necessarie, riutilizzare gli artefatti già generati e mantenere l'ambiente sicuro e monitorabile.
Una buona prassi di base consiste nello strutturare la pipeline in fasi ben definite: compilazione, test e distribuzione . Idealmente, si dovrebbe compilare una sola volta, generare un artefatto (binario, pacchetto, immagine Docker) che venga testato in parallelo in diverse varianti (ad esempio, varie versioni linguistiche) e quindi distribuire lo stesso artefatto negli ambienti di staging e di produzione senza ricompilare.
Lavorare con artefatti immutabili archiviati in repository (S3, Nexus, Artifactory, registri di container o pacchetti incorporati in GitLab/GitHub) semplifica le attività di audit, consente ripristini rapidi delle versioni e riduce la probabilità che "funzioni sulla mia macchina ma non in produzione".
Prerequisiti: distribuzione, utente CI e hardening del server
Prima di perdersi in ottimizzazioni al millisecondo, è fondamentale stabilire una base stabile sul server Linux che fungerà da esecutore CI/CD. Questo inizia con la scelta della distribuzione e della configurazione di sicurezza minima.
L'approccio più sensato è solitamente quello di standardizzare su una distribuzione LTS o stabile con cui il team ha familiarità: Ubuntu LTS, Debian Stable o alternative enterprise come AlmaLinux o Rocky Linux. Avere tutti i runner sulla stessa versione previene comportamenti imprevisti causati da librerie o kernel diversi tra i vari job.
Un altro consiglio è quello di configurare un utente dedicato per CI, senza privilegi di root, con sudo molto limitato ai soli comandi essenziali (ad esempio, systemctl o docker (se strettamente necessario). Questo utente deve autenticarsi tramite chiavi SSH, sia per accedere al server che per interagire con repository Git o altre macchine remote.
A livello di sistema, è consigliabile mantenere il server aggiornato e minimamente rinforzatoCiò include l'applicazione di aggiornamenti di sicurezza, la configurazione di un firewall restrittivo (ad esempio, con UFW: negando tutto il traffico in entrata tranne quello necessario e consentendo il traffico in uscita) e l'abilitazione di strumenti come fail2ban per fermare gli attacchi di forza bruta su SSH e regolare alcuni parametri di rete e del kernel tramite sysctl per migliorare l'affidabilità e le prestazioni.
Ad esempio, è comune aumentare il limite di inotify per evitare che i sistemi di build che monitorano molti file esauriscano le risorse e per regolare il parametro vm.swappiness per rendere il kernel più conservativo nell'utilizzo dello swap, un aspetto particolarmente rilevante quando i processi di CI consumano molta memoria contemporaneamente.
Cache, Docker e parallelizzazione: le leve prestazionali nella CI/CD
Se si analizza come viene impiegato il tempo in una pipeline media, si noterà che una parte considerevole viene persa nell'installazione delle dipendenze e nella ricostruzione delle immagini Docker . Risolvere questo problema è solitamente più efficace che ottimizzare il codice di test di pochi millisecondi.
Il primo strumento è la memorizzazione nella cache delle dipendenze . Quasi tutti i gestori di dipendenze (pip, npm, Maven, Gradle, moduli Go, ecc.) utilizzano directory di cache locali. Su un server Linux persistente, è possibile condividere queste directory tra i job o montarle su un volume persistente. In questo modo, ogni esecuzione non dovrà scaricare nuovamente metà di Internet.
Per Docker, abilita Kit di costruzione e struttura bene il Dockerfile Questo segna una svolta. Posizionare l'installazione delle dipendenze subito dopo la copia del file dei requisiti e prima del resto del codice garantisce il riutilizzo dei layer finché le versioni di tali dipendenze rimangono invariate. Inoltre, è possibile configurare cache specifiche per pip, npm, ecc., all'interno del processo di build stesso.
La seconda leva principale è la esecuzione parallela dei testMolti framework supportano nativamente la concorrenza: pytest con -n autoStrumenti Java come Surefire, Jest in JavaScript con --maxWorkersecc. Suddividere la suite per moduli, cartelle o persino in base al tempo stimato e distribuirla tra più lavoratori consente di ridurre da 2 a 5 volte la durata della fase di test senza modificare alcuna linea di business.
Infine, c'è la questione degli artefatti e del deployment . Invece di ricompilare la stessa immagine per gli ambienti di staging, pre-produzione e produzione, l'approccio più efficiente consiste nel compilare una sola volta, salvare il risultato in un repository e taggarlo in base all'ambiente di deployment. Questo riduce l'utilizzo della CPU, evita incoerenze e velocizza significativamente le pipeline lunghe.
Ottimizzazione di Jenkins, GitHub Actions e GitLab Runner su Linux
Ogni sistema di CI ha le sue peculiarità, ma tutti beneficiano degli stessi principi di base quando vengono eseguiti su Linux. La chiave consiste solitamente nell'utilizzare executor effimeri e puliti , mantenere una cache persistente di dimensioni adeguate e controllare la concorrenza.
In Jenkins, una pratica comune è quella di utilizzare agenti leggeri e temporanei (come container Docker o pod in Kubernetes o altre soluzioni di orchestrazione di container ) per eseguire i job, mantenendo il nodo master il più semplice possibile. Questi agenti possono essere configurati come servizi systemd sui server Linux, registrandosi con il controller e avviandosi automaticamente all'avvio della macchina.
Per le GitHub Actions con runner self-hosted, si consiglia di distribuirle in Macchine virtuali Linux con SSD velociPer creare una directory di cache di grandi dimensioni dedicata alle azioni (dipendenze del linguaggio, cache di build, ecc.), limitare il numero di processi simultanei per evitare di sovraccaricare la CPU e il disco. Sfruttare l'azione di caching ufficiale con percorsi come ~/.cache/pip, ~/.npm o ~/.m2 Fa un'enorme differenza in termini di tempo.
In GitLab Runner, la scelta tra l'executor shell e Docker dipende dal giusto equilibrio tra prestazioni e isolamento. L'executor shell è più veloce perché viene eseguito direttamente sull'host, ma l'executor Docker offre ambienti puliti e replicabili. È inoltre possibile configurare la cache condivisa (locale o su S3) e regolare il numero massimo di processi simultanei per sfruttare al meglio l'hardware senza sovraccaricarlo.
In tutti questi casi, disporre di volumi condivisi per la cache delle dipendenze, evitando al contempo che gli spazi di lavoro si ingombrino tra una build e l'altra, è fondamentale. Le macchine o i container effimeri, che vengono creati e distrutti con ogni pipeline o gruppo di pipeline, riducono notevolmente i problemi del tipo "funzionava ieri, ma oggi non funziona" causati dai residui delle build precedenti.
Prestazioni del server Linux: CPU, memoria, I/O e Docker
Indipendentemente da quanto siano ottimizzati i tuoi script, se il server Linux che esegue la pipeline non è dimensionato correttamente, ti imbatterai in code infinite e processi che procedono a rilento. Una configurazione tipica e ragionevole per una macchina di fascia media prevede 4-8 vCPU e 8-16 GB di RAM , con storage SSD (idealmente NVMe) e un po' di spazio di swap (2-4 GB) per gestire i picchi di carico senza interrompere bruscamente i processi.
Anche il file system è importante. ext4 o XFS con l'opzione noatime Nei volumi in cui compili o scrivi i log, riduci l'I/O non necessario. Inoltre, montando un tmpfs per file temporanei o artefatti di breve durata (ad esempio, /mnt/ci-tmp) velocizza le operazioni intensive e impedisce che il disco si riempia di file residui tra un'attività e l'altra.
Per quanto riguarda Docker, l'igiene del demone è fondamentale. La rimozione sicura e regolare di immagini e volumi non utilizzati, mantenendo al contempo immagini di base attive, contribuisce a controllo dello spazio su disco e dei tempi di avvioComandi come docker system prune Grazie a filtri temporali appropriati, consentono la pulizia senza sovraccaricare le risorse utilizzate di recente.
Se la tua CI è ad alta intensità di container, puoi anche utilizzare registri mirror per evitare di scaricare sempre da Internet, usare BuildKit per la concorrenza e la cache dei layer e persino configurare affinità CPU (set di CPU) o nodi dedicati per gli executor più esigenti, prevenendo interferenze tra carichi di lavoro adiacenti. Inoltre, comprendere la microarchitettura della CPU ti aiuta a dimensionare meglio le risorse per carichi di lavoro CI intensivi.
Sicurezza nella pipeline (DevSecOps) e implementazioni su Linux
Una pipeline veloce ma insicura è una bomba a orologeria. Integrare la sicurezza nella pipeline stessa e nella sicurezza dei container Docker è ormai uno standard in qualsiasi strategia DevSecOps, e Linux offre molti strumenti per questo scopo.
La prima cosa da fare è trattare segreti e credenziali con la massima cura . Non dovrebbero mai risiedere nel codice o in file di configurazione versionati. Al contrario, vanno archiviati in gestori di segreti (variabili mascherate di GitLab, segreti crittografati di GitHub, HashiCorp Vault, ecc.) e inseriti solo durante l'esecuzione del job che ne ha bisogno, utilizzando, ove possibile, token di breve durata.
Un altro livello importante è la generazione delle distinte base software (SBOM) e la firma degli artefatti. Strumenti come Syft o CycloneDX consentono di elencare tutti i componenti che costituiscono un'immagine o un file binario, mentre Cosign o altre soluzioni di firma verificabile garantiscono che vengano distribuiti solo gli artefatti che hanno completato l'intero processo e sono stati validati.
In termini di rete e accesso, è consigliabile segmentare le reti CI e di produzione , implementare firewall rigorosi, controllare i log di esecuzione e ruotare regolarmente le credenziali. Laddove si utilizzi SSH, è preferibile utilizzare certificati o chiavi con data di scadenza piuttosto che password statiche.
Quando si effettua il deployment su Linux, strategie come Blue/Green, rolling e canary riducono notevolmente l'impatto degli errori di deployment. Eseguire l'applicazione come servizio systemd, posizionare un Nginx o HAProxy davanti ad essa e controllare il traffico tra le versioni con controlli di integrità consente di ottenere tempi di inattività praticamente nulli durante gli aggiornamenti.
Ad esempio, quando si ricarica Nginx e si riavviano i servizi con systemd utilizzando segnali di arresto soft (come SIGTERMCon tempi di attesa ragionevoli, è possibile interrompere le connessioni attive prima che il processo si arresti, mantenendo intatta l'esperienza utente durante il passaggio di versione in background.
Osservabilità, metriche e costi nelle pipeline Linux
Una volta che le pipeline sono operative, il passo successivo è misurarle e capire come vengono impiegati tempo e risorse . Non basta sapere se un flusso di lavoro ha successo o fallisce; è necessario monitorare la durata di ogni fase, il tempo di attesa in coda, il tasso di successo, la frequenza di implementazione, il tasso di successo della cache e così via.
È comune esportare le metriche di sistema utilizzando node_exporterCentralizza i log con soluzioni come ELK o Loki e visualizza tutto nelle dashboard di Grafana. In questo modo puoi rilevare, ad esempio, se la fase di test è aumentata del 30% nell'ultima settimana o se i job impiegano troppo tempo ad attendere un executor disponibile; monitoraggio del traffico di rete Gli strumenti open source completano tale visibilità.
È anche possibile strumentare la pipeline stessa, ad esempio in GitHub Actions o GitLab CI, per per misurare programmaticamente quante esecuzioni hanno avuto successo, quanto è durata ogni esecuzione e qual è lo stato generaleUno script che chiama l'API del fornitore, calcola il numero totale di esecuzioni, il numero di esecuzioni riuscite, il numero di esecuzioni non riuscite, il tasso di successo e la durata media e salva tutto in un file JSON (come pipeline-metrics.json) consente di integrare queste metriche in report o dashboard.
Grazie a queste informazioni, è possibile prendere decisioni in merito alle dimensioni e al numero dei runner : a volte è meglio avere più runner di piccole dimensioni piuttosto che pochi runner molto grandi, per ridurre i tempi di attesa. L'autoscalabilità, ad esempio tramite cloud autoscaling o pool dinamici di nodi Kubernetes, aiuta ad assorbire i picchi di attività durante il giorno e a minimizzare le risorse sottoutilizzate durante la notte.
Queste pratiche non solo migliorano l'esperienza del team, ma contribuiscono anche a contenere i costi dell'infrastruttura controllando il consumo di CPU, memoria e soprattutto di spazio di archiviazione, che tende a lievitare con immagini e cache se non vengono pulite regolarmente e in modo pianificato.
Padroneggiare sia le classiche pipeline da riga di comando che le moderne pipeline CI/CD in Linux offre una combinazione potente: permette di automatizzare qualsiasi operazione, dalle semplici attività di filtraggio del testo a pipeline di build, test e distribuzione complesse, manutenibili, sicure e veloci. Comprendere come le informazioni fluiscono tra i processi, come vengono memorizzate nella cache le dipendenze, come vengono ottimizzati i server e come vengono integrate metriche e sicurezza consente di creare flussi di lavoro scalabili in base alle esigenze del team e dei progetti, senza diventare un collo di bottiglia costante.
